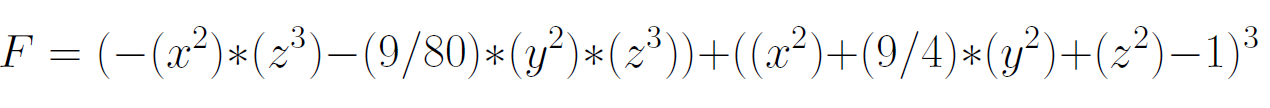lunes, 27 de junio de 2016

GoogleMaps + Bubble plot en R

En esta entrada muestro cómo graficar referencias geográficas empleando GoogleMaps y R. Para empezar necesitamos referencias geográficas que deseemos plotear, en mi caso graficaré unidades económicas de la Comisión Federal de Electricidad de los estados de Tlaxcala y Puebla, los datos los obtuve del Directorio Estadístico Nacional de Unidades Económicas (DENUE) del INEGI.

Instalamos y cargamos la librería

install.packages('RgoogleMaps')
library(RgoogleMaps)

Posterior a ello, definimos algunos parámetros como el zoom de nuestro mapa, la latitud y la longitud centro, y adicional a ello una distancia (Euclidiana) que será el radio de círculos concéntricos a partir de nuestro centro.

z0 <- 8                     # zoom
y0 <- 19.040442             # Latitud zero
x0 <- -98.250160            # longitud zero
k  <- 0.4                   # Define el salto del circulo
                            # Saltos de 11 Km por cada décima

Colocaremos en el centro del mapa (o cualquier coordenada), un marcador que nos indique alguna referencia adicional.

markers = paste0("&markers=color:blue|label:I|19.040442,-98.250160")

Acto seguido, obtener nuestro mapa base:

PuebMap  <- GetMap(center= c(y0,x0), zoom=z0, GRAYSCALE = TRUE,
             size=c(640,640),markers=markers,
             destfile = file.path(tempdir(),"interm.png"),
             maptype = 'mapmaker-hybrid')

Enseguida, importamos nuestra base de datos de las unidades económicas, la cual deberá tener una estructura parecida a esto:

> head(DF)
       id      lat       lon        x1 x2
1 3535207 18.87717 -97.72655   87.5724  3
2 3398690 18.49201 -97.40435 1167.6320 40
3 3263793 19.04774 -98.04557   87.5724  3
4 3467483 19.12102 -98.24399 1167.6320 40
5 3316191 18.95277 -97.91986   87.5724  3
6 3457112 19.06409 -98.23185   87.5724  3


x1 y x2 representan variables cuantitativas a representar mediante un gráfico de burbujas. Lo siguiente es elaborar el gráfico sobre nuestro mapa base.

tpm <- bubbleMap(DF,coords=c("lon","lat"),
                 crs=sp::CRS("+proj=longlat +datum=WGS84"),
                 max.radius=500,legendLoc="bottomright",
                 filename = file.path(tempdir(),"interm.png"),
                 map=PuebMap,zcol='zinc',
                 key.entries = c(100,250,500,750,2500,6000));

Lucirá de la siguiente manera:


Lo siguiente que haremos será graficar n círculos concentricos de radio n*k en nuestro mapa, con las siguientes líneas de comando:

r1 <- k*1
r2 <- k*2
r3 <- k*3
n  <- seq(0,359,0.05)
a  <- seq(1,360,0.05)
theta <- (360*n)/a

     x1 <- x0 + r1*cos(theta)
     y1 <- y0 + r1*sin(theta)

     x2 <- x0 + r2*cos(theta)
     y2 <- y0 + r2*sin(theta)

     x3 <- x0 + r3*cos(theta)
     y3 <- y0 + r3*sin(theta)

circle <- data.frame(c(x1,x2,x3),c(y1,y2,y3))

N <-length(x1)                        # Tamaño del vector
color <- c()                          # Inicializo vector
color[1:N]           <- 'gold'
color[(N+1):(2*N)]   <- 'darkorange'
color[(2*N+1):(3*N)] <- 'red'

{PlotOnStaticMap(PuebMap, lat = circle[,2], 
                lon = circle[,1], cex=0.5, pch=19,
                destfile = "interm.png", 
                col= color ,add=TRUE)};

Quedará algo como esto:


Podemos definir un nuevo nivel de zoom:


Por último y con fines de análisis geoespacial, para definir en que radio se encuentra cada una de las Unidades Económicas (UE), empleamos las siguientes líneas:

D <- dim(DF)[1]; D
# Este vector me indica si la Unidad Económca se encuentra en el área del radio 1 o no
DF$PotR1 <- NULL
for(j in 1:D){
    if (((DF[j,2] - y0)^2 + (DF[j,3] - x0)^2) <= r1^2){
      DF[j,'PotR1'] <- 'dentro'
      } else DF[j,'PotR1'] <- 'fuera'
}
# Este vector me indica si la Unidad Económca se encuentra en el área del radio 2 o no
DF$PotR2 <- NULL
for(j in 1:D){
    if (((DF[j,2] - y0)^2 + (DF[j,3] - x0)^2) <= r2^2){
      DF[j,'PotR2'] <- 'dentro'
      } else DF[j,'PotR2'] <- 'fuera'
}
# Este vector me indica si la Unidad Económca se encuentra en el área del radio 3 o no
DF$PotR3 <- NULL
for(j in 1:D){
    if (((DF[j,2] - y0)^2 + (DF[j,3] - x0)^2) <= r3^2){
      DF[j,'PotR3'] <- 'dentro'
      } else DF[j,'PotR3'] <- 'fuera'
}

Finalmente, en este ejemplo, se analiza a las variables cuantitativas en función de su pertenencia o no al área definida por cada radio, tal como el número de posibles empleados en cada radio:

sumER_1 <- 0
for (j in 1:D){
if (DF[j,'PotR1']=='dentro'){
    sumER_1 <- DF[j,'pers']+ sumER_1
    }
}
sumER_1                       # Potencial Radio 1

sumER_2 <- 0
for (j in 1:D){
if (DF[j,'PotR2']=='dentro'){
    sumER_2 <- DF[j,'pers']+ sumER_2
    }
}
sumER_2 <- sumER_2 - sumER_1             
sumER_2                       # Potencial Radio 2

sumER_3 <- 0
for (j in 1:D){
if (DF[j,'PotR3']=='dentro'){
    sumER_3 <- DF[j,'pers']+ sumER_3
    }
}
sumER_3 <- sumER_3 - sumER_2 - sumER_1   
sumER_3                       # Potencial Radio 3


sumER_x <- sum(DF['pers']) - sumER_1 - sumER_2 - sumER_3
sumER_x                       # Potencial fuera de cualquier radio


Información que finalmente representamos en una tabla:

> potencial <- data.frame(rbind(c(sumER_1, sumER_2, sumER_3, sumER_x)
+                               )
+                         )
> colnames(potencial) <- c(' Radio 1', ' Radio 2', ' Radio 3', ' Radio 4')
> rownames(potencial) <- 'Empleados'
> round(potencial)
           Radio 1  Radio 2  Radio 3  Radio 4
Empleados     1539      372      398      128

Lo que nos indica que existen aproximadamente 1539 empleados en el radio 1, que enfatizemos es de 44 Km a partir de la coordenada central que hemos fijado.

martes, 7 de junio de 2016

Visualización de interacciones de Twitter con R (1 de 2)

En esta entrada muestro la visualización de interacciones de Twitter, con ayuda de R y tomando sólo como ejemplo el hashtag "#PRI", una vez que han pasado las elecciones.

Los paquetes necesarios son "graphTweets", "networkD3" y "igraph". Se emplea la información de 1,000 tweets del 5 de junio de 2016. Nuestra red lucirá así:


 Y si analizamos la formación de comunidades, nuestra red se verá de la siguiente forma:

Existen otros paquetes de R con los cuales también podemos graficar las interacciones como "rgl" o "tcltk".

sábado, 4 de junio de 2016

Plot de la función de producción Cobb-Douglas en R

El propósito de esta entrada, es mostrarles principalmente una, de las seguramente muchas formas que existen en R, para generar un gráfico en tres dimensiones de la función de producción Cobb-Douglas (linealizada en este caso).
Cabe destacar que no se requiere de paquetería especial alguna, pero que el código necesario para producir el gráfico es ligeramente extenso y es posible que nos perdamos en algún momento. Mi recomendación es que lo copies, y que trates de "desmenuzarlo" poco a poco, con el objetivo de comprenderlo y posteriormente realizar las modificaciones que se ajusten a tus necesidades.

El primer paso es la base de datos, para los que se encuentran familiarizados con la función de producción Cobb-Douglas resultará sencillo entender la estructura que debe tener la base de datos, para los que no, recomiendo que lean un poco al respecto a fin de poder seguir todo el proceso. Los datos deben lucir de la siguiente manera:

En la imagen se muestran los primeros 6 datos de la base que utilizaremos en este ejemplo y que tiene el nombre de cd. La columna Y representa el valor de producción, K el valor del factor Capital, y finalmente L es el valor del factor Trabajo; todos estos valores son en realidad, el logaritmo neperiano del verdadero valor monetario ($), efectuado así para representar linealmente la función.

Lo siguiente que debemos hacer es estimar los coeficientes (elasticidades) de los factores de producción con el siguiente código:

cd.lm <-     lm(formula= I(Y) ~ I(K) + I(L),
             data  = cd, na.action=na.exclude );summary( cd.lm )

Call:
lm(formula = I(Y) ~ I(K) + I(L), data = cd, na.action = na.exclude)

Residuals:
    Min      1Q  Median      3Q     Max 
-0.2812 -0.0938 -0.0030  0.0904  0.3340 

Coefficients:
            Estimate Std. Error t value             Pr(>|t|)    
(Intercept)   2.7235     0.2644   10.30 < 0.0000000000000002 ***
I(K)          0.4566     0.0632    7.23       0.000000000067 ***
I(L)          0.8845     0.0577   15.32 < 0.0000000000000002 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Residual standard error: 0.131 on 111 degrees of freedom
Multiple R-squared:  0.817,     Adjusted R-squared:  0.814 
F-statistic:  248 on 2 and 111 DF,  p-value: <0.0000000000000002

A partir de este punto, es que comenzamos a plotear la función de producción, si sigues paso a paso el siguiente código, podrás identificar que parte del gráfico es la que se esta desarrollando.

getOption("device") ()                    ## Abre ambiente gráfico
interval <- 1
x <-   seq(from = floor(min(cd$K)/interval)*interval,
           to   = ceiling(max(cd$K)/interval)*interval,
           by   = interval)

y <-   seq(from = floor(min(cd$L)/interval)*interval,
           to   = ceiling(max(cd$L)/interval)*interval,
           by   = interval)

f <-function(x,y){
   coef(cd.lm)[1] + x*coef(cd.lm)[2] + y*coef(cd.lm)[3]
   }

z <- outer(x,y,f)

zlim <- c(floor(min(z)), ceiling(max(z)))
#Alternativa zlim <- c(floor(min(z)), 1)

cd$Y.hat <- f(x = cd$K, y = cd$L)

## Comienza el plot 3D con argumentos específicos

cd.persp <- persp(
          x        = x,
          y        = y,
          z        = z,
          theta    = 310,
          phi      = 0,
          col      = 'cornflowerblue',
          ltheta   = -135,
          shade    = 0.01,
          ticktype = 'detailed',
          main     = 'Función de producción',
          xlab     = 'Capital',
          ylab     = 'Trabajo',
          zlab     = 'Valor producción',
          zlim     = zlim,
          scale    = TRUE,
          border   = NA,
          nticks   = 4 ,
          font.lab = 2)

# Se plotean los valores reales

cd.below <- subset(cd, cd$Y <= cd$Y.hat)

cd.below.trans3d <- trans3d(
       x    = cd.below$K,
       y    = cd.below$L,
       z    = cd.below$Y,
       pmat = cd.persp )

points( cd.below.trans3d, col = "red", pch = 16)

cd.below.hat.trans3d <- trans3d(
      x    = cd.below$K,
      y    = cd.below$L,
      z    = cd.below$Y.hat,
      pmat = cd.persp )

segments(
   x0  = cd.below.trans3d$x,
   y0  = cd.below.trans3d$y,
   x1  = cd.below.hat.trans3d$x,
   y1  = cd.below.hat.trans3d$y,
   lty = "solid",
   col = "red")

cd.above <- subset (cd, cd$Y >= cd$Y.hat)

cd.above.trans3d <- trans3d(
       x    = cd.above$K,
       y    = cd.above$L,
       z    = cd.above$Y,
       pmat = cd.persp )

points (cd.above.trans3d, col = "green", pch = 16)

cd.above.hat.trans3d <- trans3d(
        x    = cd.above$K,
        y    = cd.above$L,
        z    = cd.above$Y.hat,
        pmat = cd.persp )

segments(
     x0  = cd.above.trans3d$x,
     y0  = cd.above.trans3d$y,
     x1  = cd.above.hat.trans3d$x,
     y1  = cd.above.hat.trans3d$y,
     lty = "solid",
     col = "green")

# Agregamos la leyenda

legend("bottom",
       c("Ajustado","Real (superior)","Real (inferior)"),
       horiz=TRUE,
       pch=c(18,19,19),
       col=c("cornflowerblue","green","red"),
       inset=0.95,
       pt.cex=c(2,1.1,1.1),
       bty="n")

El resultado será (dependiendo de tus datos), un gráfico como el que se presenta al inicio. Sin embargo, tenemos otra vía que requiere muchas menos líneas de código; aunque cabe mencionar que existen algunas diferencias en cuanto a estética se refiere. Para elaborarlo requerimos de un paquete denominado scatterplot3d. Una vez instalada esta paquetería, procedemos con el siguiente código:

library(scatterplot3d)


cd.lm <-     lm(formula= I(Y) ~ I(K) + I(L),
             data  = cd, na.action=na.exclude );summary( cd.lm )

s3d <- scatterplot3d(cd$K,cd$L,cd$Y,
       pch=16,highlight.3d=TRUE,
       type="h",main="Función de producción")
s3d$plane3d(cd.lm)


Lo que produce un gráfico como el siguiente:

Claro está que existen más argumentos para esta función (scatterplot3d), lo que podría producir un gráfico de mejor calidad, aunque corresponde al usuario indagar para lograr el objetivo que busca.

viernes, 3 de junio de 2016

Plotear un corazón 3D en R

En esta ocasión, después de no publicar en un largo tiempo, me doy a la tarea escribir algo con menor carga académica, pero que quizás en determinado momento, ya sea por curiosidad o por alguna necesidad tengas el interés en replicar e inclusive mejorar.

Plotear un corazón (de San Valentín) en dos o tres dimensiones en algún Software no es algo novedoso, sin duda que no lo es, existen numerosos códigos en Matlab, Mathematica, C, etc., regados por Internet. Pero para los que utilizamos mayormente R, aquí esta la alternativa.

El único paquete que necesitamos es misc3d, y plotear la siguiente función:

En donde, tanto x, y como z, son vectores que van desde -3 a 3, con intervalos k, una vez explicado esto, lo único que debemos hacer escribir las siguientes lineas de código:

# install.packages('misc3d')
library(misc3d)

k <- 0.030
x <- seq(-3, 3, by = k);x
y <- seq(-3, 3, by = k);y
z <- seq(-3, 3, by = k);z

f  <- function(x ,y, z)(-(x^2)*(z^3)-(9/80)*(y^2)*(z^3)) + ((x^2)+(9/4)*(y^2)+(z^2)-1)^3
contour3d(f,0,x,y,z, color='red', smooth=TRUE, fill= TRUE)


Existen algunos argumentos de la función que bien valdría la pena explorar, todo acorde a tus necesidades. También es valioso comentar que el intervalo k, entre más pequeño sea, mejor apariencia tendrá nuestro gráfico, pero el tiempo que tomará R para plotearlo será mayor.

sábado, 16 de enero de 2016

Función personalizada en Excel: EDAD a través del RFC

Cómo parte de las actividades de comercialización, en ocasiones es necesario segmentar por edades una base de datos (cartera de clientes o prospectos). Si conocemos su RFC (Registro Federal de Contribuyentes) o su CURP (Clave Única de Registro de Población), tenemos los elementos necesarios para establecer su fecha de nacimiento y con ello su edad.

En Excel existen diferentes funciones preestablecidas con las que podemos trabajar estos cálculos, particularmente yo recurrí por un tiempo a la siguiente:

Como vemos, es una fórmula relativamente extensa , que si se aplica con frecuencia, la lógica nos indica que deberíamos crear nuestra propia función y así simplificar el trabajo. Fue así que me decidí por hacerla y en las siguientes líneas escribo el código de Visual Basic.

Function EDAD(RFC As String) As Integer
'
' EDAD Macro
' Calcula la edad a partir del RFC o CURP del cliente
'
Dim fecha As Date
Dim anio As String
Dim DIA As String
Dim MES As String
    
    hoy = DateValue(Now)
    current = Year(hoy) - 2000
    DIA = Mid(RFC, 9, 2)
    MES = Mid(RFC, 7, 2)
        If Val(Mid(RFC, 5, 2)) < current Then
        anio = Val(Mid(RFC, 5, 2)) + 2000
    Else
        anio = Val(Mid(RFC, 5, 2)) + 1900
    End If
    fecha = DIA & "/" & MES & "/" & anio
    EDAD = Int(DateDiff("d", fecha, hoy) / 365.25)
  
End Function

En donde RFC, es una celda que contiene una secuencia de valores alfanum éricos  y cuyos primeros 10
dí gitos son del tipo ABCD650123, tanto para el caso del RFC como de la CURP.
, el resultado es una función con una sintaxis sumamente sencilla:

=EDAD(Celda_RFC_o_CURP)

Con lo que nuestra celda luce ahora así:


Para descargar el archivo con la función personalizada pulsa aquí.
También elaboré un pequeño tutorial para su instalación el cual puedes descargar dando click aqui.

Espero que les sea de utilidad, ya que puede ser explotado en diversas áreas.

lunes, 14 de diciembre de 2015

Estratificación univariada: Dalenius-Hodges en R

En ocasiones necesitamos efectuar clasificaciones de diversos elementos de un solo género o tipo en particular, es decir, considerando una sola variable, ejemplo de ello podría ser la necesidad de clasificar los sueldos (una variable) en 5 diferentes estratos o niveles A, B, C, D y E, en donde el nivel de sueldo A es el segmento de más altos ingresos y el E el correspondiente más bajo. Dicho lo anterior tenemos el siguiente conjunto de datos de salarios de 197 individuos.

salario <-c (
 4289.73, 4406.78, 4488.95, 4571.12, 4812.87, 4843.74, 4851.71, 4890.56, 4914.12, 4933.78, 
 5018.10, 5040.95, 5044.34, 5066.85, 5078.80, 5110.44, 5119.41, 5124.68, 5130.99, 5135.34, 
 5177.40, 5191.48, 5193.40, 5197.50, 5279.18, 5290.13, 5290.16, 5296.33, 5384.02, 5397.73, 
 5409.40, 5411.93, 5416.75, 5445.54, 5472.65, 5723.95, 5725.31, 5731.29, 5969.58, 6022.41, 
 6095.31, 6097.05, 6130.07, 6169.46, 6198.34, 6280.46, 6316.52, 6328.47, 6343.44, 6357.36, 
 6357.45, 6360.44, 6371.10, 6376.79, 6403.20, 6413.09, 6428.10, 6434.53, 6440.06, 6448.47, 
 6470.93, 6472.14, 6481.34, 6486.56, 6490.19, 6493.81, 6501.03, 6504.24, 6515.35, 6520.18, 
 6521.95, 6526.74, 6532.13, 6537.66, 6554.48, 6570.43, 6571.21, 6573.25, 6574.21, 6574.52, 
 6574.73, 6581.37, 6586.18, 6591.89, 6593.38, 6642.02, 6651.42, 6665.15, 6684.61, 6688.75, 
 6716.94, 6728.25, 6729.34, 6729.89, 6736.86, 6738.59, 6740.44, 6764.47, 6768.74, 6776.44, 
 6781.90, 6786.11, 6793.99, 6798.21, 6800.80, 6828.71, 6829.09, 6831.70, 6832.51, 6837.67, 
 6841.04, 6845.12, 6848.01, 6848.14, 6864.57, 6875.00, 6875.52, 6883.97, 6887.47, 6897.43, 
 6913.51, 6914.35, 6930.79, 6934.43, 6940.40, 6947.90, 6949.91, 6950.31, 6961.26, 6970.46, 
 6989.58, 7001.53, 7006.66, 7012.12, 7019.46, 7031.67, 7259.44, 7267.55, 7356.75, 7359.73, 
 7382.94, 7431.07, 7433.44, 7446.43, 7455.70, 7493.88, 7511.72, 7520.14, 7535.55, 7544.52, 
 7594.32, 7615.39, 7679.87, 7763.58, 7769.01, 7840.14, 7890.94, 7921.94, 7962.78, 7973.63, 
 7990.67, 8015.57, 8313.88, 8571.07, 8607.91, 8625.85, 8646.75, 8825.33, 8868.16, 8953.81, 
 8963.78, 9034.30, 9121.13, 9150.03, 9151.02, 9176.92, 9203.81, 9207.80, 9209.56, 9214.77, 
 9261.35, 9271.31, 9282.27, 9415.62, 9433.66, 9535.25, 9536.25, 9559.16, 9560.15, 9573.10, 
 9708.63,20850.56,29298.05,43287.22,43419.52,43437.22,73458.19)

El método de Dalenius-Hodges forma estratos en los cuales la varianza es mínima intra-grupos y máxima inter-grupos, es decir, forma grupos lo más homogéneos posible.

En R, debemos instalar el paquete stratification, posteriormente cargar esta librería con el comando:

library(stratification)

Y posteriormente, para efectuar la estratificación:

strata.cumrootf(salario, CV=0.05, Ls=5)

En donde , salario es el vector de datos, CV es el coeficiente de variación objetivo, y Ls es el número de estratos que deseamos.

R nos da como resultado los límites superiores de cada estrato, los cuales se toman cerrados por la derecha (límite superior) y abiertos por la izquierda (límite inferior), a excepción del primero que se considera cerrado por ambos lados. El resultado de la clasificación de salarios que se tomó como ejemplo es:

E - [4,289.73 ,  6,134.22 ]
D - (6,134.22 ,  7,056.47]
C - (7,056.47 ,   7,978.71]
B - (7,978.71 ,   9,823.21]
A - (9,823.21 , 73,459.19]

sábado, 14 de noviembre de 2015

Mapeo en Stata 2 de 2

En la anterior entrada mostramos como mapear los poligonos que representaban a las entidades de México de manera simple, en la presente tomaremos como ejemplo para mapear el estado de Puebla y algunas variables tomadas del Censo de Población y Vivienda 2010.

En primer lugar, y retomando lo publicado en la anterior entrada, mapeamos exclusivamente en la localidad Heróica Puebla de Zaragoza y con las divisiones por AGEB (Área Geoestadística Básica), con los siguientes comandos:

shp2dta using ageb_urb, database(agebdb) coordinates(agebcoord)
use agebdb, clear
spmap using agebcoord if cve_loc==211140001, id(_ID) fcolor(blue*0.5)


El siguiente paso será mapear el porcentaje de Población Económicamente Activa (PEA) por AGEB, de la siguiente manera:

spmap PEA using agebcoord if cve_loc==211140001, id(_ID) clnumber(20) fcolor(Blues2) ocolor(none ..) legstyle(3) legend(ring(1) position(3)) ndfcolor(red)


En donde:

clnumber(20) = Número de rangos que deseamos en la variable.
fcolor(Blues2) = Esquema de coloreo que deseamos en los polígonos, este tipo en particular admite hasta 99 categorias, y funciona perfectamente en variables continuas.
ocolor(none ..) = Indica que no queremos colorear el contorno de los polígonos.
legstyle(3) = Índica el estilo de la leyenda, este tipo es el indicado para este ejemplo.
ndfcolor(red) = El color para los polígonos donde no se tiene información.